Jeg har problemer med at kopiere teksten fra et scannet dokument.
Løst af OCR PDF
Problemet
Du har et scannet dokument, hvorfra du ønsker at udtrække visse tekstinformationer. Dog er kopieringen af teksten problematisk på grund af, at det scannede dokument i bund og grund er et billede. Hertil kommer det besværliggjort faktum, at du gerne vil have tekstinformationerne i et redigerbart format for at kunne rette potentielle fejl. Dette viser sig at være særligt svært, hvis teksten er skrevet i hånden. Derfor leder du efter en løsning til at digitalisere teksten fra dit scannede dokument effektivt og præcist, og have det i et redigerbart format.
Skærmbilleder
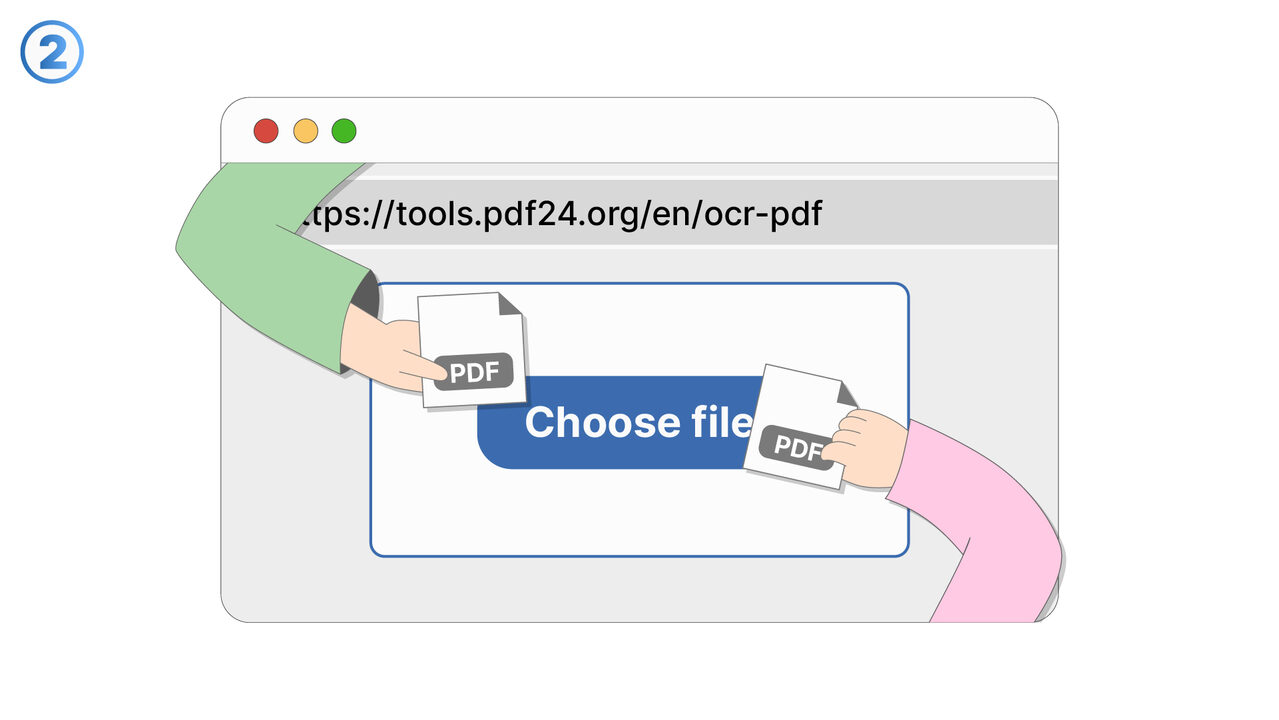
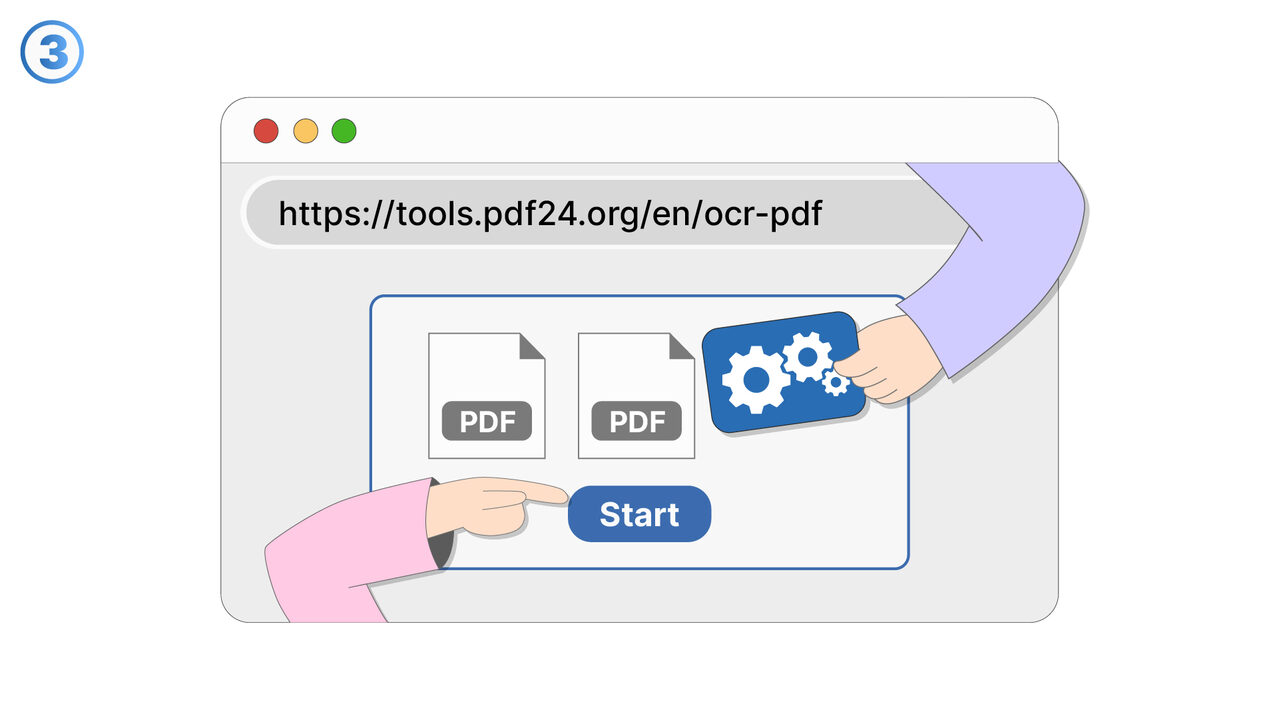
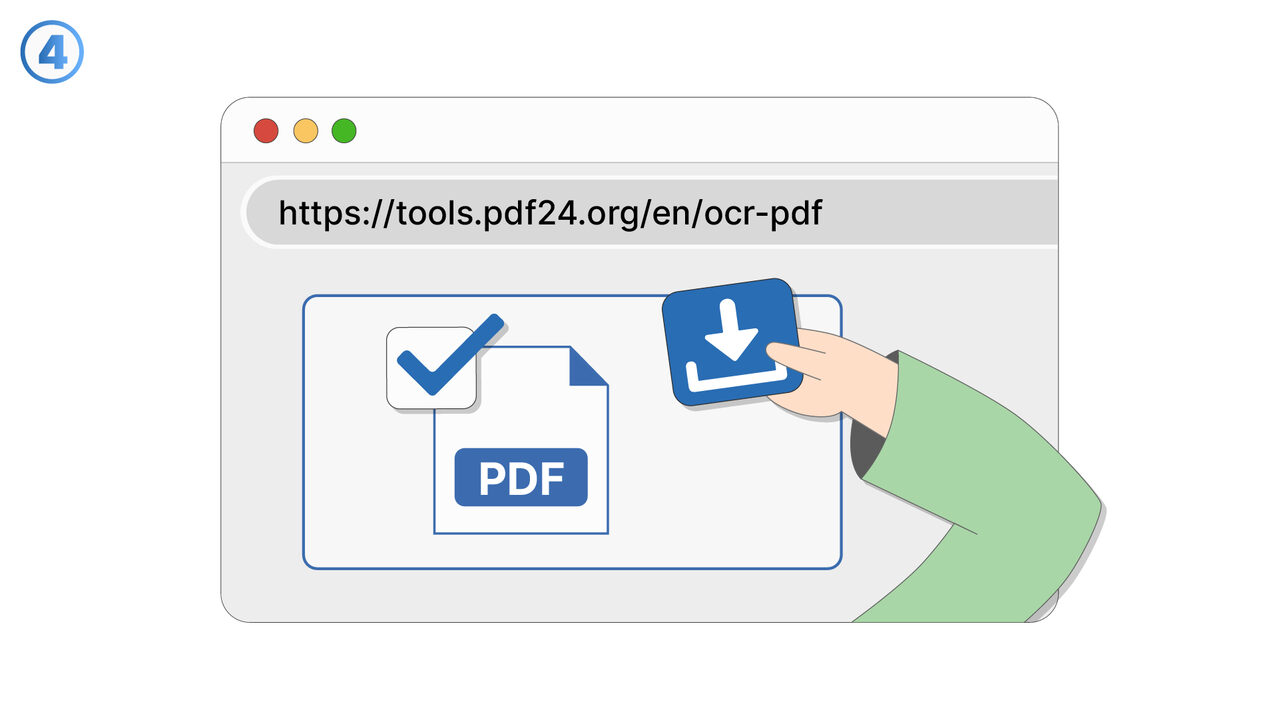
Løsningen
OCR PDF-værktøjet er en effektiv løsning på dit problem. Det bruger optisk tegngenkendelse til at ekstrahere tekst fra dit scannet dokument, som i bund og grund er et billede. Det er i stand til at genkende både skrevet og håndskrevet tekst og konvertere det til digital form. Dette gør teksten i din PDF ikke kun læsbar, men også søgbar og indekserbar. Fejl kan du nemt rette takket være dette værktøj, da teksten er i et redigerbart format. Selv håndskrevet tekst er ikke et problem, så længe håndskriften er klar og tydelig. Ved at bruge OCR PDF-værktøjet kan du gøre digitaliseringen og styringen af dine dokumenter betydeligt mere effektiv og produktiv.
Ekstern ressource
https://tools.pdf24.org/en/ocr-pdf
Brug dette værktøj som en løsning på følgende problemer
- Jeg kan ikke redigere teksten i min PDF-fil og har brug for en løsning på det.
- Jeg har problemer med at digitalisere gamle papirdokumenter.
- Jeg kan ikke søge i indholdet af min PDF-fil og har brug for et værktøj til tekstgenkendelse.
- Jeg har problemer med at udtrække og digitalisere tekst fra fysiske dokumenter.
- Jeg kan ikke rette fejl i mine scannede PDF-dokumenter.
- Jeg har problemer med at ekstrahere og administrere teksten fra mine fysiske dokumenter.
- Jeg har svært ved at udtrække tekst fra fysiske dokumenter og dele dem digitalt.
- Jeg kan ikke indeksere og kategorisere teksten i min scannede PDF.
- Jeg har svært ved at konvertere teksten fra billedbaserede PDF'er til redigerbar tekst.
Kender du en bedre løsning? Lad os vide det.
Hvis du kender et værktøj eller en tilgang, der kan hjælpe folk med at løse et problem, vi endnu ikke har dækket, hører vi gerne fra dig.